少重读 · 上下文编译
按当前任务从台账与资料中编译出聚焦上下文,默认预算 5,000 token。Agent 不再每轮重读整个项目。
AWR 替你的 AI 编程助手管好三件事:项目进度、当前任务要用的资料、跨会话交接记录。换个会话、换个 Agent(Codex → Claude Code → Kimi),项目不必重新开场。
npm install -g @originoneai/agent-work-runtime@0.4.0
python -m pip install agent-work-runtime==0.4.0
$ awr ready
→ 下一个任务  AWR-SITE-006 官网首屏改版
  依赖已满足 · 认领后即可开工

$ awr context --task AWR-SITE-006
✓ 聚焦上下文已编译:4,998 tokens
  全文资料 18,955 → -73.6%
  依据 GOALS.md · PLAN.md · work-ledger.yaml

$ awr checkpoint "首屏改版完成,待部署"
✓ 检查点已回写台账 —— 换会话、换 Agent 可接续

$ ▋
预编译版本覆盖 macOS 15+(Apple Silicon 与 Intel)、Linux x64、Windows x64(Node 22.14+ 或 Python 3.9+),npm 或 pip 任选其一。不用学新概念,装完先发一句话。
给你的 Coding Agent 发一句简单的话即可:
请使用 AWR(@originoneai/agent-work-runtime)来接管整个项目吧
已经有长任务或者台账了,可以用 /goal 让它持续执行:
你用 AWR 来维护接管整个项目,以它为基准,以开发、回归测试、真实测试、修复/优化、提交代码、Push 远端、进行下一项 这样的顺序依次进行,直至全部完成
第一次试用,重点观察一件事:完成一部分工作并留下记录以后,换个会话,新 Agent 能否根据现有资料接上下一步。不用替它重新讲整个项目,同时它又知道哪些事情尚未验证,这才是一次有意义的接续体验。
按当前任务从台账与资料中编译出聚焦上下文,默认预算 5,000 token。Agent 不再每轮重读整个项目。
会话、检查点与交接机制承接「换会话继续干」:核对目标、来源变化、未完成任务,再接续依赖已满足的工作。
Markdown / YAML 始终是权威来源,资料留在原文件;SQLite 只存索引与运行状态。全部在本地,不上云。
同一工作分支的一项任务只能有一个有效认领;过期写入受版本检查约束,旧会话不能拿旧状态覆盖新进度。
Rust 核心,上下文编译在本地完成、不额外调用模型,实测 p95 延迟 108ms。预编译覆盖 macOS(Apple Silicon / Intel)、Linux、Windows 四大目标。
命令行 awr 与 MCP 服务 awr-mcp:本地 stdio 20 种工具;共享 HTTP 服务 21 种工具,一个端点服务多项目、多客户端,持久会话断线可接续。支持 status-map / field-map 映射已有台账字段。
长任务开发的方法并不神秘:先规划、留台账、控制粒度。但知道应该留记录,和真正管得住越来越多的资料、任务和会话,是两回事。AWR 接手的,就是这部分重复劳动。
今天 Codex,明天想让 Kimi 接着做,后天请 Claude Code 复核。新执行者不知道哪些结论已确认、哪些只是写了代码、哪些还没验收——业务又得从头讲一遍。
只是修一个转派问题,Agent 却重读需求、架构和整份台账。会话用得久了不断压缩:大方向还记得,交代过的细节开始漏。
复制资料、解释背景、核对进度、提醒别碰错地方。台账把记录留下来了,找出当前真正要用的那一部分,仍是重复劳动。
接入 AWR 后,Agent 每次拿到的是当前这项工作的资料,而不是整个项目的全部历史。整个开发过程的信息流因此改变:
目标、方案、规则、台账留在 Markdown / YAML 里,它们仍是权威来源。
按当前任务编译出真正要用的那部分资料,SQLite 建索引,本地完成、不调模型。
拿到聚焦后的上下文,再去读相关代码、修改实现、执行测试。
状态、验证结果、阻塞和下一步写回记录,下一个执行者据此接续。
新的进度、证据和下一步继续回写,循环进入下一轮
以下数字来自仓库自带的公开合成基准:上下文对比为 150 个合成任务(逐一测量全部 39 个未完成任务),token 按 o200k_base 计数,预算 5,000,测试环境 Apple M3 Max;工作流对比为 0.4.0 的 30 / 45 次合成运行。各组数字相互独立,不可叠加。
| 口径 | 数值 | 说明 |
|---|---|---|
| 全文资料 | 18,955 tokens | 把项目全部资料交给 Agent 的输入量 |
| 聚焦后单任务上下文(最大) | 4,998 tokens | AWR 按当前任务编译出的上下文,减少 73.6% |
| 完整 CLI JSON | -32.7% | 不走聚焦编译、直接发送完整 JSON 时的降幅 |
| 合并任务准备(0.4.0 work prepare) | 调用 -18~27% · 文本 -3.4~4.7% | 就绪判断、必要上下文、管理要求一次返回,对比等效旧流程(30 次合成运行) |
| 摘要响应(0.4.0 可选) | 文本 -6.8~9.2% | 调用次数不变,累计返回文本降幅(45 次合成运行) |
| 上下文编译延迟 | p95 = 108ms | 本地编译,无需额外调用模型 |
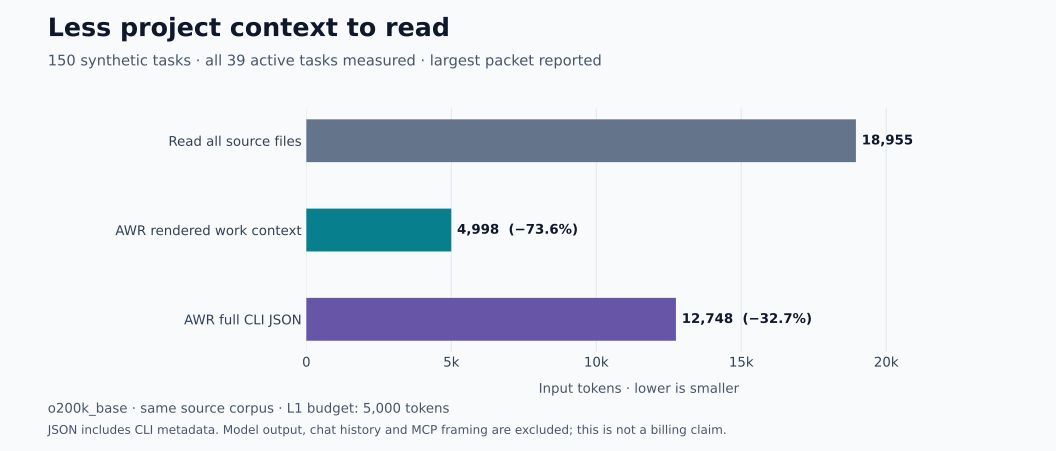
诚实注:这些数字衡量的是「输入给 Agent 的资料量」与「交互往返成本」,不等于端到端的账单节省。实际节省取决于你的任务结构、台账质量和使用的模型计费方式;三组对比相互独立,降幅不可叠加。
Mem0 提供记忆的组织、更新和检索,也能用于任务相关记忆。但「记下我们做过工单转派」,与「管理工单转派当前能不能继续」,需要的机制不同。两者互补,不存在谁替代谁的结论。
| Mem0(记忆服务) | AWR(工作管理) | |
|---|---|---|
| 核心问题 | 我们做过什么、用户偏好是什么 | 这项工作当前能不能继续、由谁继续 |
| 管理对象 | 记忆内容的组织、更新与检索 | 任务状态、约束、上下文与接续动作 |
| 要回答的事 | 按用户、Agent、会话或任务范围找回内容 | 前置模块完成了吗、现在谁在做、证据对应哪版代码、旧会话能否覆盖新进度、下一个执行者该拿到哪些资料 |
| 关系 | 记忆服务和工作管理可以配合:已经有目标和项目资料、需要跨阶段跨会话持续推进时,AWR 围绕台账把这些组织起来。 | |
解决「换会话继续开发」:上下文编译、检查点与恢复、任务认领、版本检查、合并任务准备与摘要响应,CLI + MCP 接入现有 Coding Agent。
共享 MCP 服务与持久工作会话已落地:一个 HTTP 端点服务多项目、多客户端,按项目显式授权,会话支持认领、检查点与断线接续。多人、多 Agent 在同一工作状态上接力。
为多用户、多租户工作平台保留扩展空间:产品界面负责展示交互,专业 Agent 负责执行,人负责确认与审核。需要说明:当前本地协作机制不等同于完整多租户成品——企业身份认证、租户权限、分布式协调和平台级运维,还需由上层系统补齐并验证。
AWR 提供 CLI(awr)与 MCP(awr-mcp)两种接口,支持 MCP 的客户端都能接:本地 stdio 20 种工具,另有共享 HTTP 服务(21 种工具)可一个端点服务多项目、多客户端。自动生命周期安装目前主要面向 Codex,其他客户端需要相应的接入配合。
全部在本地:Markdown / YAML 资料留在原文件,索引与运行状态存在本地 SQLite。不上云。
不会。Markdown / YAML 始终是权威来源,Markdown 台账继续在原文件编辑;受支持的 YAML 台账走受控更新,遇到过期来源和版本冲突先检查,不拿旧状态直接覆盖。
用 status-map / field-map 把你已有的字段命名映射到 AWR 的工作模型,不必为了接入重写历史台账。
Apache-2.0。欢迎试用、点 Star,也欢迎带着脱敏的真实问题提 Issue,贡献客户端适配、任务模板、恢复测试和平台集成。